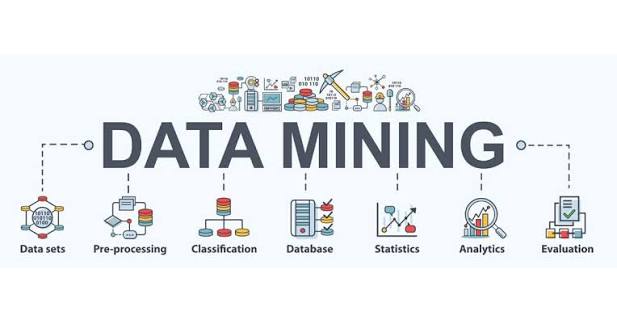
دادهکاوی (Data Mining) فرایند کشف الگوها، روابط، گروهها و ناهنجاریهای مفید در مجموعهدادههاست. در این فرایند از روشهای آماری، یادگیری ماشین، تحلیل داده و فناوریهای پایگاه داده استفاده میشود تا اطلاعات خام به شناختی قابلاستفاده برای تصمیمگیری تبدیل شود.
دادهکاوی فقط جستوجو در یک پایگاه داده یا تهیه نمودار نیست. هدف آن پاسخدادن به پرسشهایی مانند «کدام مشتریان احتمال بیشتری برای خرید دارند؟»، «چه عواملی با خرابی یک تجهیز ارتباط دارند؟» یا «کدام تراکنشها رفتاری غیرعادی نشان میدهند؟» است. نتیجه ممکن است یک مدل پیشبینی، گروهبندی دادهها، مجموعهای از قواعد یا گزارشی از الگوهای کشفشده باشد.
دادهکاوی چگونه کار میکند؟
تصور کنید یک فروشگاه اطلاعات سفارشها، زمان خرید، نوع کالا و سابقه مشتریان را ثبت میکند. با تحلیل این دادهها میتوان محصولاتی را که معمولاً با هم خریداری میشوند شناسایی کرد، مشتریان را بر اساس الگوی خرید گروهبندی نمود یا احتمال بازگشت مشتری را برآورد کرد. ارزش دادهکاوی زمانی مشخص میشود که نتیجه به یک تصمیم عملی، قابلاندازهگیری و متناسب با مسئله منجر شود.
دادههای موردنیاز ممکن است از نرمافزارهای فروش و مالی، سامانههای ارتباط با مشتری، سوابق سفارش، فایلهای عملیاتی، گزارشهای دستگاهها یا منابع دیگر جمعآوری شوند. در پروژههای سازمانی، کیفیت و یکپارچگی سامانههای مبدأ اهمیت زیادی دارد. برای آشنایی با بسترهای نرمافزاری سازمان، میتوانید صفحه خدمات سامانههای سازمانی را ببینید.
تفاوت دادهکاوی با تحلیل داده، یادگیری ماشین و کشف دانش چیست؟
دادهکاوی و تحلیل داده
تحلیل داده اصطلاحی گسترده است و میتواند شامل گزارشگیری، بررسی روندها، آزمون فرضیهها، مصورسازی و اندازهگیری شاخصها باشد. دادهکاوی بیشتر بر کشف الگوها و روابطی تمرکز دارد که از بررسی ساده دادهها بهراحتی آشکار نمیشوند. در عمل، این دو حوزه همپوشانی دارند و اغلب در یک پروژه بهصورت مکمل به کار میروند.
دادهکاوی و یادگیری ماشین
یادگیری ماشین مجموعهای از روشها برای ساخت مدلهایی است که از دادهها الگو میآموزند. دادهکاوی میتواند از الگوریتمهای یادگیری ماشین استفاده کند، اما به آن محدود نیست؛ روشهای آماری، قواعد وابستگی و تحلیل اکتشافی نیز ممکن است بخش مهمی از پروژه باشند. از سوی دیگر، هر مدل یادگیری ماشین الزاماً یک پروژه دادهکاوی نیست.
دادهکاوی و کشف دانش در پایگاه دادهها
کشف دانش در پایگاه دادهها (KDD) معمولاً به فرایند گستردهتری اشاره دارد که از انتخاب و آمادهسازی داده شروع میشود و تا تحلیل، ارزیابی و تفسیر نتایج ادامه پیدا میکند. دادهکاوی یکی از مراحل اصلی این مسیر است؛ تمیزکردن، آمادهسازی و تفسیر دادهها را نباید با اجرای الگوریتم بهتنهایی یکی دانست.
مراحل اجرای یک پروژه دادهکاوی
پروژه موفق با انتخاب الگوریتم شروع نمیشود. ابتدا باید مسئله کسبوکار مشخص شود، سپس دادهها بررسی و آماده شوند و در نهایت نتیجه از نظر دقت، سودمندی و قابلیت استفاده در شرایط واقعی ارزیابی شود. مدل CRISP-DM یک چارچوب شناختهشده برای سازماندهی این مراحل است. مراحل آن الزاماً یک مسیر خطی نیستند و ممکن است بر اساس نتیجه ارزیابی تکرار شوند.
۱. درک مسئله و هدف کسبوکار
پیش از جمعآوری یا مدلسازی، هدف باید دقیق تعریف شود. برای مثال، «بهبود فروش» هدفی کلی است؛ اما «برآورد احتمال خرید مجدد مشتری در سه ماه آینده» پرسشی قابلارزیابیتر است. شاخص موفقیت، محدودیتهای زمانی، هزینه خطا و افرادی که از خروجی استفاده میکنند نیز باید تعیین شوند.
۲. شناخت دادهها
در این مرحله منابع داده، معنا و نوع فیلدها، بازه زمانی، تعداد رکوردها، مقادیر گمشده، دادههای تکراری و محدودیتهای دسترسی بررسی میشوند. باید مشخص شود که آیا دادههای موجود واقعاً برای پاسخ به مسئله کافی هستند یا لازم است منبع دیگری اضافه شود.
۳. پاکسازی و آمادهسازی دادهها
دادههای ناقص یا ناسازگار، قالبهای متفاوت تاریخ، مقادیر غیرعادی، رکوردهای تکراری و خطاهای ورود اطلاعات میتوانند نتیجه را منحرف کنند. آمادهسازی شامل اصلاح یا مدیریت این موارد، ترکیب منابع، ساخت ویژگیهای مناسب و جداکردن دادههای لازم برای ارزیابی مدل است.
در این مرحله باید مراقب نشت اطلاعات (Data Leakage) بود؛ یعنی اطلاعاتی که در زمان پیشبینی واقعی در دسترس نخواهد بود، بهصورت ناخواسته وارد دادههای آموزش شود. وجود چنین اطلاعاتی میتواند عملکرد ظاهری مدل را بسیار بهتر از عملکرد واقعی نشان دهد.
۴. انتخاب روش و ساخت مدل
روش مناسب به نوع پرسش و شکل خروجی موردنیاز بستگی دارد. برای پیشبینی یک مقدار عددی، رگرسیون ممکن است مناسب باشد؛ برای تشخیص گروههای مشابه، خوشهبندی؛ و برای یافتن تراکنشهای غیرعادی، روشهای تشخیص ناهنجاری قابل بررسی هستند. بهتر است چند مدل پایه و قابلمقایسه ساخته شوند تا انتخاب نهایی فقط بر اساس پیچیدگی الگوریتم انجام نشود.
۵. ارزیابی نتایج و اعتبارسنجی
نتیجه مدل باید روی دادههایی که برای آموزش آن استفاده نشدهاند آزمایش شود. روش تقسیم داده، اعتبارسنجی متقابل و شاخص ارزیابی باید با نوع مسئله سازگار باشند. همچنین لازم است عملکرد مدل با یک روش پایه و با هزینه واقعی خطا مقایسه شود.
۶. استفاده عملی و پایش
پس از تأیید مدل، باید مشخص شود خروجی آن چگونه در فرایند کاری استفاده میشود، چه کسی مسئول کنترل نتایج است و در صورت افت عملکرد چه اقدامی انجام میشود. تغییر الگوهای رفتار مشتری، شرایط بازار یا دادههای ورودی ممکن است به بازبینی دورهای مدل نیاز داشته باشد.
مهمترین روشها و وظایف دادهکاوی
طبقهبندی (Classification)
طبقهبندی برای پیشبینی یک برچسب یا گروه از پیش تعریفشده استفاده میشود. تشخیص پیام ناخواسته، دستهبندی درخواستهای پشتیبانی یا پیشبینی اینکه یک تراکنش نیازمند بررسی بیشتر است، نمونههایی از این کاربرد هستند.
رگرسیون (Regression)
رگرسیون برای برآورد یک مقدار عددی به کار میرود؛ مانند تخمین تقاضای آینده، پیشبینی زمان انجام یک فرایند یا برآورد هزینه بر اساس ویژگیهای ثبتشده. ارزیابی آن معمولاً باید میزان خطا را در مقیاسی متناسب با مسئله نشان دهد.
خوشهبندی (Clustering)
خوشهبندی دادههای مشابه را بدون نیاز به برچسب از پیش تعیینشده در گروههایی قرار میدهد. این روش میتواند برای شناخت الگوهای خرید، گروهبندی رفتار کاربران یا بررسی شباهت رخدادها استفاده شود. گروههای بهدستآمده لزوماً معنای کسبوکاری مشخصی ندارند و باید پس از ایجاد، تفسیر و اعتبارسنجی شوند.
قواعد وابستگی و تحلیل سبد خرید
قواعد وابستگی روابط پرتکرار میان اقلام یا رویدادها را شناسایی میکنند. اگر دو محصول اغلب در یک سفارش ظاهر شوند، این رابطه میتواند برای طراحی پیشنهادهای تکمیلی مفید باشد. بااینحال، هموقوعی دو رویداد لزوماً به معنای رابطه علت و معلولی نیست.
تشخیص ناهنجاری (Anomaly Detection)
این روش مواردی را مشخص میکند که نسبت به رفتار معمول تفاوت قابلتوجهی دارند. کاربردها میتوانند شامل بررسی تراکنشهای مشکوک، خطاهای دستگاهها یا فعالیت غیرعادی در گزارشهای عملیاتی باشند. خروجی الگوریتم معمولاً نشانهای برای بررسی بیشتر است و نباید بدون شواهد کافی معادل اثبات تقلب یا تخلف تلقی شود.
تحلیل توالی و خلاصهسازی
تحلیل توالی به بررسی ترتیب رخدادها در طول زمان میپردازد؛ برای نمونه، مسیر انجام مراحل یک سفارش یا توالی رویدادهای ثبتشده در یک سامانه. خلاصهسازی نیز مجموعه بزرگی از اطلاعات را به نمایش فشردهتری مانند گزارش، شاخص یا الگو تبدیل میکند.
یک مثال عملی از دادهکاوی در کسبوکار
فرض کنید یک شرکت میخواهد علت کاهش خرید مجدد مشتریان را بررسی کند. دادههای سفارش، تاریخ خرید، نوع محصول، کانال فروش و سوابق خدمات گردآوری میشوند؛ سپس کیفیت دادهها و میزان کاملبودن آنها بررسی میشود.
- تعریف مسئله: مشخصکردن اینکه «خرید مجدد» چگونه تعریف و در چه بازهای اندازهگیری میشود.
- آمادهسازی: یکپارچهسازی سوابق سفارش و مدیریت موارد ناقص یا تکراری.
- تحلیل اکتشافی: مقایسه رفتار گروههای مختلف مشتریان و بررسی روندها.
- مدلسازی: در صورت نیاز، ساخت مدل طبقهبندی برای برآورد احتمال خرید مجدد.
- ارزیابی: سنجش عملکرد روی دادههای مستقل و بررسی هزینه خطاهای مثبت و منفی.
- اقدام عملی: طراحی مداخله محدود و قابلاندازهگیری و بررسی اینکه آیا نتیجه واقعاً بهبود یافته است.
این فرایند به معنای قطعیبودن پیشبینی نیست. مدل میتواند به تصمیمگیری کمک کند، اما نتایج باید با دانش کسبوکار، کیفیت دادهها و شواهد حاصل از اجرا سنجیده شوند.
چه ابزارهایی برای دادهکاوی استفاده میشوند؟
پایگاه داده و SQL
SQL برای انتخاب، ترکیب و خلاصهسازی دادههای ذخیرهشده در بسیاری از پایگاههای رابطهای کاربرد دارد. در پروژههایی که دادهها از چند منبع به دست میآیند، طراحی مناسب جداول، کیفیت اتصال رکوردها و تعریف درست شاخصها پیشنیاز تحلیل قابلاعتماد است.
Python و R
Python و R ابزارهای پرکاربرد تحلیل آماری، آمادهسازی داده، مصورسازی و مدلسازی هستند. انتخاب ابزار باید بر اساس مهارت تیم، نیاز فنی پروژه، قابلیت نگهداری و سازگاری با محیط اجرایی انجام شود؛ استفاده از یک زبان خاص بهتنهایی تضمینکننده کیفیت خروجی نیست.
انبار داده و پردازش توزیعشده
انبار داده میتواند اطلاعات منابع مختلف را برای تحلیلهای سازمانی سازماندهی کند. برای برخی مجموعهدادههای بسیار بزرگ یا پردازشهای توزیعشده، فناوریهایی مانند Hadoop یا Apache Spark قابل بررسیاند. بااینحال، بسیاری از پروژهها با یک پایگاه داده متعارف، زیرساخت مناسب و ابزارهای تحلیل متناسب قابل اجرا هستند. حجم داده بهتنهایی دلیل کافی برای مهاجرت به یک معماری پیچیده نیست.
برای مطالعه بیشتر درباره یکی از فناوریهای پردازش توزیعشده، آشنایی با Hadoop را ببینید. استفاده از این فناوریها باید با نیاز واقعی پروژه سنجیده شود.
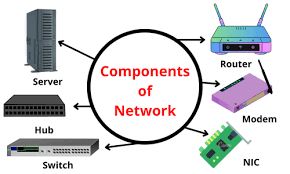
در پروژههای سازمانی، پایداری زیرساخت فناوری اطلاعات، دسترسپذیری منابع و مدیریت صحیح سامانههای مبدأ نیز اهمیت دارند. برای آشنایی با ساختار زیرساخت، مقاله راهنمای جامع شبکههای کامپیوتری را ببینید.
چگونه کیفیت یک مدل دادهکاوی را ارزیابی کنیم؟
یک شاخص واحد برای همه پروژههای دادهکاوی مناسب نیست. انتخاب معیار باید به هدف، نوع داده و هزینه اشتباهها وابسته باشد.
- طبقهبندی: دقت، Precision، Recall و F1 میتوانند تصویر کاملتری از عملکرد ارائه دهند؛ بهویژه وقتی تعداد نمونههای گروهها نامتوازن است.
- رگرسیون: معیارهایی مانند MAE و RMSE میزان خطای پیشبینی عددی را از جنبههای متفاوت نشان میدهند.
- خوشهبندی: سنجههای داخلی، پایداری گروهها و تفسیرپذیری آنها باید همراه با شناخت مسئله بررسی شوند.
- قواعد وابستگی: فراوانی، اطمینان و معیارهای مکمل برای مقایسه قواعد بررسی میشوند؛ یک رابطه پرتکرار لزوماً از نظر کسبوکار ارزشمند نیست.
- کشف ناهنجاری: باید بررسی شود که چه تعداد از هشدارها مفید هستند و بار بازبینی موارد اشتباه چقدر است.
تقسیم درست داده به بخشهای آموزش و آزمون، پیشگیری از نشت اطلاعات، مقایسه با مدل پایه و آزمایش روی دادههای مستقل، به ارزیابی واقعبینانهتر کمک میکنند.
خطاهای رایج در پروژههای دادهکاوی
شروع از الگوریتم بهجای مسئله
پیادهسازی یک الگوریتم پیچیده بدون هدف عملی روشن، میتواند خروجی پرهزینهای ایجاد کند که در تصمیمگیری به کار نمیآید. ابتدا باید پرسش، معیار موفقیت و محدودیتهای اجرا مشخص شوند.
نادیدهگرفتن کیفیت داده
مقادیر گمشده، دادههای تکراری، خطاهای ثبت و ناسازگاری منابع بر کیفیت مدل اثر میگذارند. افزایش پیچیدگی الگوریتم الزاماً مشکل ورودی نامناسب را برطرف نمیکند.
بیشبرازش (Overfitting)
بیشبرازش زمانی رخ میدهد که مدل به ویژگیهای خاص داده آموزش بیشازحد وابسته شود و روی نمونههای جدید عملکرد ضعیفتری داشته باشد. استفاده از داده آزمون مستقل، اعتبارسنجی مناسب، کنترل پیچیدگی و مقایسه با مدل پایه میتواند این خطر را کاهش دهد.
تعبیر رابطه بهعنوان علت
کشف همبستگی بهتنهایی نشان نمیدهد که یک عامل علت مستقیم نتیجه است. پیش از تغییر فرایند یا سیاست کسبوکار، باید محدودیتهای داده، عوامل مخدوشکننده و در صورت لزوم طرحهای آزمایشی مناسب بررسی شوند.
استفادهنکردن از مدل پس از ساخت
مدلی که گزارش آن تولید شده اما در تصمیم واقعی استفاده نمیشود، ارزش محدودی ایجاد میکند. فرایند تحویل باید مسئول مشخص، روش پایش، زمان بازبینی و معیارهای توقف یا بازآموزی مدل را تعیین کند.
حریم خصوصی و ملاحظات اخلاقی در دادهکاوی
دادهکاوی ممکن است الگوهایی درباره رفتار، ترجیحات یا فعالیتهای افراد آشکار کند؛ حتی اگر دادهها در ابتدا فاقد نام و مشخصات مستقیم باشند. ترکیب منابع مختلف گاهی امکان شناسایی مجدد افراد را ایجاد میکند. بنابراین حذف نام یا شماره شناسایی بهتنهایی تضمین ناشناسماندن کامل داده نیست.
- هدف جمعآوری و استفاده از دادهها باید روشن و متناسب با نیاز باشد.
- فقط دادههای لازم برای مسئله جمعآوری و نگهداری شوند.
- دسترسی به دادهها و خروجی مدل بر اساس نقش و نیاز افراد محدود شود.
- اطلاعات حساس در زمان ذخیرهسازی و انتقال، با کنترلهای مناسب محافظت شوند.
- محدودیتهای ناشناسسازی و خطر شناسایی مجدد در ارزیابی ریسک لحاظ شوند.
- در تصمیمهایی که بر افراد اثر جدی میگذارند، امکان بازبینی انسانی و رسیدگی به خطاها در نظر گرفته شود.
روشهای حفاظت از داده باید متناسب با نوع اطلاعات، زمینه استفاده و الزامات قابلاعمال انتخاب شوند. راهنمای NIST درباره کاهش خطر شناسایی مجدد دادهها، توضیحات تکمیلی در این زمینه ارائه میکند.
چه زمانی استفاده از دادهکاوی ارزش دارد؟
دادهکاوی زمانی گزینه مناسبی است که مسئله تصمیمگیری مشخصی وجود داشته باشد، دادههای کافی و مرتبط در دسترس باشند، هزینه اشتباه قابلبررسی باشد و نتیجه بتواند در یک فرایند واقعی مورد استفاده قرار گیرد.
اگر مسئله صرفاً شمارش فروش ماهانه یا نمایش تعداد درخواستهاست، گزارشگیری معمول شاید کافی باشد. اما اگر سازمان بخواهد گروههای پنهان مشتریان را شناسایی کند، احتمال رخداد آینده را برآورد نماید یا موارد غیرعادی را از میان دادههای فراوان پیدا کند، روشهای دادهکاوی میتوانند ارزش بیشتری داشته باشند.
پرسشهای متداول درباره دادهکاوی
آیا دادهکاوی فقط برای شرکتهای بزرگ مناسب است؟
خیر. مقیاس پروژه باید با مسئله، میزان داده و منابع موجود متناسب باشد. سازمانهای کوچک نیز میتوانند با مجموعهدادههای محدود و یک پرسش مشخص از تحلیل الگوها استفاده کنند؛ به شرط آنکه کیفیت داده و ارزش عملی نتیجه بررسی شود.
آیا برای دادهکاوی حتماً به هوش مصنوعی نیاز داریم؟
خیر. بعضی مسائل با روشهای آماری، قواعد وابستگی یا تحلیل اکتشافی حل میشوند. یادگیری ماشین یکی از خانوادههای مهم روشهای دادهکاوی است، نه تنها راه ممکن.
آیا دادهکاوی همیشه رفتار آینده را دقیق پیشبینی میکند؟
خیر. نتیجه به کیفیت داده، روش انتخابشده، شرایط مسئله و تغییرات محیط وابسته است. عملکرد مدل باید روی داده مستقل ارزیابی و پس از استفاده واقعی نیز پایش شود.
آیا برای دادههای زیاد باید حتماً Hadoop نصب کرد؟
خیر. انتخاب پلتفرم به حجم و سرعت ورود داده، نوع پردازش، محدودیت زمان، زیرساخت و هزینه نگهداری وابسته است. برای بسیاری از پروژهها ابزارهای متعارف کافیاند؛ پردازش توزیعشده زمانی مطرح میشود که نیاز واقعی پروژه آن را توجیه کند.
تفاوت دادهکاوی و داشبورد مدیریتی چیست؟
داشبورد معمولاً شاخصها و وضعیت فعلی یا گذشته را خلاصه میکند. دادهکاوی میتواند به کشف گروهها و روابط پنهان یا ساخت مدلهای پیشبینی کمک کند. این دو میتوانند در یک راهکار تحلیلی مکمل یکدیگر باشند.
جمعبندی
دادهکاوی زمانی ارزشمند است که یک پرسش روشن را با دادههای قابلاعتماد، روش مناسب و ارزیابی واقعبینانه دنبال کند. درک مسئله، آمادهسازی دقیق داده، انتخاب روش متناسب، بررسی خطاها و حفاظت از حریم خصوصی بهاندازه انتخاب الگوریتم اهمیت دارند. خروجی نهایی نیز باید قابلتفسیر، قابلاستفاده و قابلپایش باشد.
منابع پیشنهادی برای مطالعه بیشتر
مشاوره و خدمات واریان شبکه گستر
دادهکاوی به دادههای مناسب و زیرساخت قابلاعتماد برای گردآوری، ذخیرهسازی و دسترسی نیاز دارد. واریان شبکه گستر در حوزه زیرساخت و خدمات فناوری اطلاعات فعالیت میکند؛ برای آشنایی با خدمات مرتبط با زیرساخت و سامانههای سازمانی، از صفحات خدمات سایت بازدید کنید.