راهاندازی سیستم مانیتورینگ و گزارشگیری شبکه، فرایندی برای مشاهده مداوم وضعیت تجهیزات، سرویسها و کیفیت ارتباطات است. هدف فقط دیدن نمودارها نیست؛ سامانه باید به تیم فنی کمک کند اختلال را زودتر تشخیص دهد، اثر آن را مشخص کند، برای رفع آن اقدام کند و روند عملکرد را در طول زمان بسنجد.
یک پیادهسازی موفق از شناخت نیازهای سازمان آغاز میشود: چه تجهیزاتی باید پایش شوند، کدام سرویسها حیاتیاند، چه رخدادی نیازمند هشدار است و گزارشها قرار است به چه تصمیمی کمک کنند؟ در این راهنما مراحل طراحی، انتخاب ابزار، تنظیم هشدارها، گزارشگیری و نگهداری را مرور میکنیم.
چرا مانیتورینگ شبکه اهمیت دارد؟
پایش پیوسته میتواند قطعی لینک، افزایش تأخیر، افت کیفیت سرویس، مصرف غیرعادی منابع و برخی نشانههای اولیه اختلال را آشکار کند. ثبت تاریخچه نیز کمک میکند مشخص شود مشکل چه زمانی آغاز شده، چه تجهیزاتی تحت تأثیر بودهاند و آیا تغییر اخیر با رویداد ارتباط دارد.
مانیتورینگ بهتنهایی جلوی تمام حملات یا خرابیها را نمیگیرد؛ ارزش آن در فراهمکردن دید، هشدار بهموقع و شواهد قابل بررسی است. نتیجه زمانی بهتر میشود که تیم مشخصی مسئول بررسی هشدارها و پیگیری رخدادها باشد.
چه مواردی را باید پایش کنیم؟
- دسترسپذیری تجهیزات: وضعیت روتر، سوئیچ، فایروال، سرور، نقاط دسترسی و پیوندهای ارتباطی.
- عملکرد و ظرفیت: مصرف CPU و حافظه، فضای ذخیرهسازی، استفاده از رابط شبکه، خطاهای پورت و پهنای باند.
- کیفیت ارتباط: تأخیر، از دسترفتن بستهها، نوسان تأخیر و وضعیت اتصال بین نقاط مهم.
- سرویسهای حیاتی: DNS، DHCP، VPN، وبسرور، پایگاه داده و سرویسهای موردنیاز کاربران.
- رخدادها و تغییرات: قطعشدن سرویس، بالا رفتن نرخ خطا، تغییر وضعیت رابط و رویدادهای ثبتشده در لاگها.
فهرست پایش را بر اساس اهمیت سرویسها تنظیم کنید. پایش تمام شاخصهای ممکن از روز اول، بدون تعریف هدف و مسئول رسیدگی، میتواند هزینه ذخیرهسازی و تعداد هشدارهای کمارزش را افزایش دهد.
اجزای معمول یک سامانه مانیتورینگ
بسته به ابزار و معماری، سامانه میتواند شامل جمعآوریکننده داده یا عامل نصبشده روی میزبان، روشهای پایش بدون عامل، سرور مرکزی یا پایگاه داده، داشبورد، سامانه هشداردهی و ماژول گزارشگیری باشد.
جمعآوری اطلاعات ممکن است با SNMP، ICMP، عامل نرمافزاری، API یا دریافت لاگ انجام شود. انتخاب روش به نوع دستگاه، میزان جزئیات موردنیاز، سازگاری و محدودیتهای امنیتی بستگی دارد. برای دسترسی به تجهیزات، از حسابهای اختصاصی با حداقل مجوز لازم استفاده کنید و اطلاعات احراز هویت را در گزارشها یا داشبوردهای عمومی نمایش ندهید.
انتخاب ابزار مانیتورینگ متناسب با شبکه
- Zabbix: سامانهای برای پایش زیرساخت، میزبانها و تجهیزات شبکه که از قالبهای آماده، کشف شبکه، داشبورد، تاریخچه داده و گزارش پشتیبانی میکند. برای جزئیات ابزار میتوانید ابزار مانیتورینگ شبکه و Zabbix را مطالعه کنید.
- Prometheus: ابزار متنباز برای جمعآوری و نگهداری متریکهای سری زمانی و ارزیابی قواعد هشدار؛ انتخاب آن باید با نوع سرویسها و روش دسترسی به متریکها هماهنگ باشد.
- Grafana: برای پرسوجو و نمایش دادههای منابع مختلف در داشبوردها و ساخت قواعد هشدار کاربرد دارد. معمولاً باید منبع داده و سامانه جمعآوری متناسب نیز پیکربندی شوند.
- PRTG، SolarWinds و ManageEngine OpManager: محصولات تجاری با امکانات متفاوت برای پایش شبکه و زیرساخت. قابلیتها، هزینه مجوز، ظرفیت واقعی و شرایط پشتیبانی باید بر اساس نسخه و نیاز سازمان بررسی شوند.
هیچ ابزار واحدی برای همه شبکهها بهترین انتخاب نیست. تعداد تجهیزات، پراکندگی شعب، نیاز به گزارشهای مدیریتی، پروتکلهای قابلپشتیبانی، مهارت تیم، بودجه و نحوه دریافت هشدار را پیش از انتخاب مشخص کنید. همچنین، برای بررسی رویکرد حرفهایتر پایش میتوانید به مانیتورینگ شبکه بهصورت حرفهای مراجعه کنید.
مراحل راهاندازی سیستم مانیتورینگ
- تهیه فهرست داراییها: تجهیزات، آدرسها، نقش هر دستگاه، سرویسهای وابسته و مسئول هر بخش را مستند کنید.
- تعیین اولویت: ابتدا سرویسهایی را انتخاب کنید که اختلال در آنها بیشترین اثر را بر کاربران یا کسبوکار دارد.
- انتخاب روش جمعآوری: برای هر نوع دستگاه، روش سازگار مانند SNMP، عامل، API یا آزمون دسترسپذیری را تعیین کنید.
- تنظیم دوره نمونهبرداری و نگهداری داده: فاصله بررسیها و مدت ذخیره تاریخچه را بر پایه نیاز عملیاتی و ظرفیت سامانه تنظیم کنید.
- ساخت داشبورد اولیه: وضعیت سرویسهای حیاتی، روند ظرفیت و رخدادهای مهم را در یک نمای قابلفهم نشان دهید.
- تعریف هشدارهای قابل اقدام: برای هر هشدار، آستانه، شدت، مسئول، کانال اطلاعرسانی و اقدام اولیه را مشخص کنید.
- آزمون و تحویل: قطع آزمایشی کنترلشده یا رخداد قابل بازگشت ایجاد کنید تا معلوم شود هشدار، اعلان و روند رسیدگی درست عمل میکنند.
چطور هشدارها را مفید تنظیم کنیم؟
آستانهها را صرفاً بر اساس اعداد عمومی انتخاب نکنید. ابتدا رفتار عادی شبکه را در ساعتها و روزهای مختلف مشاهده کنید و سپس محدودهای را تعریف کنید که از نظر سازمان واقعاً نیازمند اقدام است. هشدار باید تا حد ممکن به علامت قابل مشاهده اختلال مربوط باشد، نه اینکه برای هر تغییر کوچک اعلان جداگانه بفرستد.
برای نمونه، اگر سرویس حیاتی در دسترس نیست، هشدار فوری میتواند ضروری باشد؛ اما افزایش کوتاه و بیاثر مصرف CPU ممکن است فقط در داشبورد ثبت شود. از دوره انتظار، تجمیع هشدارهای تکراری و تعیین مسئول مشخص استفاده کنید تا خستگی هشدار کاهش یابد. راهنمای رسمی Prometheus درباره طراحی هشدارها نیز بر هشدارهای ساده و قابل اقدام تأکید میکند.
گزارشگیری شبکه و شاخصهای کاربردی
گزارش مناسب به پرسشی مشخص پاسخ میدهد: آیا سرویس در دسترس بوده است؟ ظرفیت کجا رو به اتمام است؟ کدام لینک خطا دارد؟ کدام رخدادها تکرار میشوند و زمان رسیدگی چقدر است؟ نمونه شاخصهای مفید عبارتاند از:
- درصد دسترسپذیری سرویسهای مهم در بازه گزارش.
- روند مصرف پهنای باند و منابع سرور و دستگاههای اصلی.
- تعداد، شدت و مدت اختلالها و هشدارهای تکرارشونده.
- زمان تشخیص و رفع رخداد، در صورت ثبت دقیق زمانها.
- ظرفیتهای نزدیک به حد بحرانی و پیشبینی زمان نیاز به توسعه.
برای محاسبه ساده دسترسپذیری در یک بازه، میتوان از رابطه زیر استفاده کرد؛ تعریف زمان توقف و بازه اندازهگیری باید در گزارش مشخص باشد:
درصد دسترسپذیری = (کل زمان بازه − زمان توقف) ÷ کل زمان بازه × ۱۰۰
گزارش مدیریتی بهتر است خلاصه، روند، اثر بر سرویس و اقدام پیشنهادی را کنار هم نشان دهد. گزارش فنی میتواند جزئیات رخداد، زمان شروع و پایان، تجهیز درگیر و شواهد عیبیابی را ارائه کند. از جمعآوری یا نمایش اطلاعات مربوط به کاربران بیش از حد لازم خودداری کنید و سیاست سازمان درباره حریم خصوصی و نگهداری لاگها را رعایت کنید.
اگر هدف اتصال پایش به ابزارهای نمایش داده و هشدار است، مستندات رسمی Grafana درباره منابع داده و ویژگیهای Zabbix نقطه شروع مناسبی هستند.
امنیت و نگهداری سامانه مانیتورینگ
- پنل مدیریتی را فقط از مسیرهای مورداعتماد در دسترس قرار دهید و از احراز هویت قوی استفاده کنید.
- حسابهای جمعآوری داده را با حداقل سطح دسترسی موردنیاز تعریف کنید.
- سامانه مانیتورینگ و عاملها را بهروز نگه دارید و دسترسیهای بلااستفاده را حذف کنید.
- از تنظیمات و دادههای ضروری پشتیبان تهیه کنید و امکان بازیابی را بیازمایید.
- برای رخدادهای مهم، مسیر اعلان جایگزین در نظر بگیرید؛ چون اگر خود سامانه پایش از کار بیفتد، ممکن است هشدار نیز ارسال نشود.
- گزارشها، داشبوردها و دسترسی به لاگها را دورهای بازبینی کنید.
خطاهای رایج هنگام پیادهسازی
- نصب ابزار پیش از تعیین هدف، داراییها و شاخصهای موفقیت.
- تعریف تعداد زیادی هشدار که مشخص نیست چه کسی باید آنها را پیگیری کند.
- نادیده گرفتن ظرفیت ذخیرهسازی و نگهداری دادههای تاریخی.
- دسترسی مدیریتی بیش از حد یا ذخیره ناامن گذرواژهها و کلیدها.
- ساخت داشبوردهای زیبا بدون تعریف اقدام عملی برای رخدادهای نمایشدادهشده.
- نداشتن آزمون برای اعلان، نسخه پشتیبان و بازیابی سامانه.
پرسشهای متداول
آیا مانیتورینگ شبکه فقط برای شبکههای بزرگ است؟
خیر. شبکههای کوچک نیز از مشاهده دسترسپذیری اینترنت، وضعیت روتر و سوئیچ، سلامت سرورها و هشدار قطعی سرویس سود میبرند. سطح پیچیدگی ابزار باید متناسب با اندازه و نیاز شبکه باشد.
چند وقت یکبار باید گزارش تهیه شود؟
این موضوع به تصمیم موردنیاز بستگی دارد. وضعیت هشدارها ممکن است نزدیک به لحظه بررسی شود؛ ظرفیت و روند عملکرد میتواند به گزارش روزانه یا هفتگی نیاز داشته باشد و گزارش مدیریتی معمولاً بر دورهای متناسب با برنامهریزی سازمان تمرکز دارد.
آیا یک ابزار برای همه تجهیزات کافی است؟
گاهی ممکن است، اما همیشه نه. برخی تجهیزات پروتکل یا API متفاوتی دارند و بعضی شاخصها به عامل یا ابزار تخصصی نیاز دارند. پیش از انتخاب، پوشش واقعی دستگاهها و نیاز گزارشگیری را در محیط آزمایشی بررسی کنید.
مطالعه تکمیلی و خدمات مرتبط
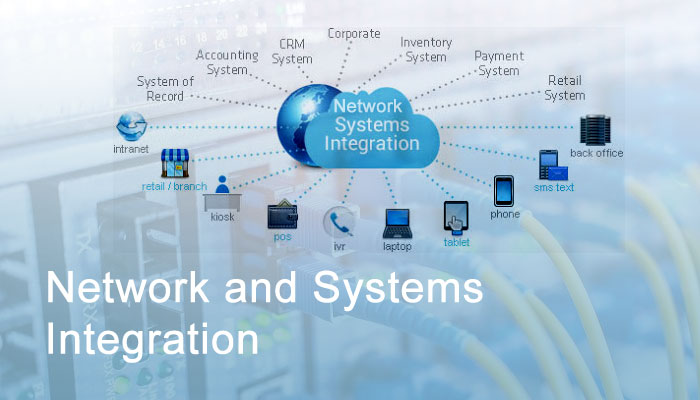
برای شناخت ساختار کلی شبکه، راهنمای جامع شبکههای کامپیوتری را ببینید. همچنین راهکارهای ارتباطی و نظارتی سازمانی درباره راهکارهای ارتباطی و نظارتی سازمانی توضیح میدهد و میتواند برای طراحی یکپارچه سامانههای نظارت مفید باشد.
جمعبندی
راهاندازی موفق مانیتورینگ شبکه با فهرستکردن داراییها، تعیین اولویت سرویسها و انتخاب روش جمعآوری آغاز میشود. پس از ساخت داشبورد، هشدارها باید قابل اقدام باشند و گزارشها به سنجش دسترسپذیری، ظرفیت و روند اختلال کمک کنند. امنیت سامانه، نگهداری داده و آزمون فرایند بازیابی نیز بخش جداییناپذیر این چرخهاند.