خلاصهٔ کاربردی: مانیتورینگ شبکه فقط بررسی روشن یا خاموش بودن تجهیزات نیست. یک سامانهٔ حرفهای باید دسترسپذیری، کیفیت ارتباط، مصرف منابع، ترافیک، خطاها و وضعیت سرویسهای مهم را پایش کند؛ سپس دادهها را به داشبورد و هشدارهای قابل اقدام تبدیل کند. هدف نهایی، تشخیص زودهنگام اختلال و کوتاهکردن زمان عیبیابی است.
هرچه شبکهٔ سازمان بزرگتر و وابستگی کسبوکار به سرویسهای دیجیتال بیشتر میشود، تشخیص اختلال از روی گزارش کاربران دشوارتر خواهد شد. ممکن است اتصال اینترنت برقرار باشد، اما یک لینک بین دو سوئیچ خطای زیادی داشته باشد؛ یا سرور پاسخ بدهد، ولی تأخیر برنامهٔ مالی و سامانهٔ ارتباطی از حد قابل قبول عبور کرده باشد. مانیتورینگ شبکه به مدیران فناوری اطلاعات کمک میکند این نشانهها را پیش از تبدیلشدن به بحران مشاهده کنند.
در این راهنما با شاخصهای مهم پایش، روشهای جمعآوری داده، پروتکلهای رایج، ابزارهای متداول، اصول طراحی هشدار و مراحل استقرار مانیتورینگ در زیرساخت سازمانی آشنا میشوید.
مانیتورینگ شبکه چیست و چه مسئلهای را حل میکند؟
مانیتورینگ شبکه فرایند جمعآوری و تحلیل مستمر اطلاعات مربوط به وضعیت تجهیزات، ارتباطات و سرویسهاست. این اطلاعات میتواند شامل دسترسپذیری روتر و سوئیچ، وضعیت رابطهای شبکه، مصرف پهنای باند، افت بسته، تأخیر، خطاهای رابط، منابع سرور و پاسخگویی یک سرویس کاربردی باشد.
یک راهکار مناسب سه قابلیت را کنار هم قرار میدهد:
- مشاهدهپذیری: مشخص میکند چه چیزی اکنون در حال رخدادن است و وضعیت در طول زمان چگونه تغییر میکند.
- هشداردهی: در صورت مشاهدهٔ نشانههای معنادار اختلال، پیام مناسب را به مسئول مربوطه میرساند.
- تحلیل و گزارشگیری: کمک میکند علت احتمالی مشکل، الگوی تکرار آن و نیازهای ظرفیت آینده شناسایی شوند.
مانیتورینگ بهتنهایی تضمینکنندهٔ جلوگیری از قطعی نیست؛ ارزش آن در آشکارکردن نشانهها، فراهمکردن شواهد و پشتیبانی از تصمیمگیری فنی است.
کدام شاخصها را باید پایش کنیم؟
انتخاب شاخص به نقش هر دستگاه و اهمیت آن برای کسبوکار وابسته است. ثبت تعداد زیادی عدد بدون هدف مشخص، معمولاً داشبورد را شلوغ میکند، اما تشخیص مشکل را آسانتر نمیسازد.
| شاخص | چه چیزی را نشان میدهد؟ | کاربرد عملی |
|---|---|---|
| دسترسپذیری | پاسخگویی دستگاه یا سرویس در بازهٔ زمانی مشخص | تشخیص قطعی تجهیزات یا سرویسهای حیاتی |
| Latency | زمان رفتوبرگشت یا پاسخگویی | شناسایی کندی ارتباط و افزایش تأخیر |
| Packet Loss | درصد بستههای ازدسترفته در آزمون | بررسی کیفیت لینک و مسیر ارتباطی |
| مصرف پهنای باند | حجم یا نرخ ورودی و خروجی رابط | شناسایی اشباع لینک و برنامهریزی ظرفیت |
| خطا و Discard رابط | خطاهای دریافت یا ارسال و بستههای حذفشده | بررسی کابل، پورت، ازدحام و ناسازگاری تنظیمات |
| CPU و حافظه | میزان مصرف منابع روتر، فایروال یا سرور | تشخیص فشار منابع و کاهش ظرفیت پردازش |
| وضعیت سرویس | سلامت DNS، وبسایت، پایگاه داده یا سامانهٔ سازمانی | تشخیص مشکلی که با روشنبودن دستگاه پنهان میماند |
| تغییرات و رویدادها | راهاندازی مجدد، تغییر پیکربندی و رخدادهای ثبتشده | همبستهسازی رویدادها با شروع اختلال |
یک آزمون Ping موفق لزوماً به معنی سالم بودن برنامه نیست. در مقابل، پاسخندادن به Ping نیز همیشه ثابت نمیکند که دستگاه از دسترس خارج شده است؛ ممکن است پاسخ ICMP در سیاست فایروال محدود شده باشد. برای سرویسهای حساس، آزمون واقعی سرویس را نیز در نظر بگیرید.
روشهای جمعآوری داده در مانیتورینگ شبکه
۱. استفاده از SNMP برای تجهیزات شبکه
پروتکل SNMP در بسیاری از روترها، سوئیچها، فایروالها، چاپگرهای شبکه و منابع تغذیهٔ بدون وقفه پشتیبانی میشود. سامانهٔ مانیتورینگ میتواند با خواندن مقادیر تعریفشده، وضعیت رابطها، شمارندههای ترافیک، زمان فعالیت و برخی شاخصهای دستگاه را دریافت کند.
برای شبکههایی که قابلیتهای امنیتی لازم را پشتیبانی میکنند، SNMPv3 با احراز هویت و محافظت از محرمانگی، در صورت پیکربندی صحیح، انتخاب مناسبتری برای مدیریت امن است. اطلاعات دسترسی را محدود کنید، دسترسی مدیریتی را فقط از سامانههای مجاز بپذیرید و سرویس SNMP را بدون نیاز واقعی در معرض اینترنت قرار ندهید. استفاده از SNMPv3 نیز بهتنهایی جایگزین کنترل دسترسی شبکه نیست.
راهنمای رسمی Zabbix دربارهٔ پایش از طریق SNMP جزئیات فنی و مراحل پیکربندی را توضیح میدهد.
۲. بررسی دسترسپذیری با ICMP و آزمونهای فعال
بررسی ICMP میتواند برای سنجش پاسخگویی، تأخیر و افت بسته مفید باشد. در کنار آن، بهتر است برای سرویسهای مهم آزمونهای کاربردی نیز تعریف شوند؛ برای مثال، بررسی پاسخ HTTP یک پرتال، امکان resolve شدن نام دامنه یا برقراری اتصال به یک سرویس حیاتی.
آزمون را از نقطهای اجرا کنید که برای کاربران یا مسیر ارتباطی موردنظر نماینده باشد. پایش از یک سرور مرکزی، بهتنهایی کیفیت تجربهٔ کاربران شعبههای دورتر را نشان نمیدهد.
۳. تحلیل جریان ترافیک
پروتکلها و سازوکارهای ثبت جریان ترافیک مانند NetFlow، sFlow و IPFIX میتوانند اطلاعاتی دربارهٔ مبدأ و مقصد جریانها، حجم ترافیک و الگوهای ارتباطی فراهم کنند. این اطلاعات برای شناسایی مصرفکنندگان عمدهٔ پهنای باند و بررسی تغییر رفتار ترافیک مفید است؛ اما با ضبط کامل بستهها یکسان نیست.
در انتخاب روش جمعآوری، بار پردازشی تجهیزات، حجم داده، حریم خصوصی و نیاز واقعی به جزئیات را در نظر بگیرید. مشخصات IPFIX در استاندارد RFC 7011 آمده است.
۴. جمعآوری لاگها و رویدادها
لاگهای روتر، سوئیچ، فایروال، سرور و سرویسها میتوانند زمان رخداد، تغییر وضعیت رابط، خطای احراز هویت یا رویدادهای امنیتی را ثبت کنند. ارسال متمرکز لاگها به سامانهای مشخص، بررسی رویدادهای چند دستگاه را آسانتر میکند.
زمان دستگاهها را هماهنگ نگه دارید، سطح ثبت رویداد را متناسب انتخاب کنید و دسترسی به لاگها را محدود کنید. مانیتورینگ عملیاتی و سامانهٔ SIEM نقشهای مرتبط اما یکسانی ندارند: مانیتورینگ عمدتاً وضعیت و عملکرد را دنبال میکند، در حالی که SIEM بر گردآوری و همبستهسازی رویدادهای امنیتی تمرکز دارد. برای آشنایی بیشتر، مقالهٔ راهنمای سامانهٔ SIEM را بخوانید.
۵. استفاده از عاملها، API و Exporterها
برای سیستمعاملها، ماشینهای مجازی و سرویسهای نرمافزاری میتوان از Agent، API یا Exporter استفاده کرد. برای مثال، Prometheus دادههای عددی را از مقصدهای پیکربندیشده جمعآوری میکند و با ابزارهای تصویری مانند Grafana میتوان آنها را در داشبورد نمایش داد. برای تجهیزات شبکهای که عامل نرمافزاری ندارند، لازم است روشهایی مانند SNMP یا Exporterهای متناسب با نیاز به کار گرفته شوند.
مستندات رسمی Prometheus معماری جمعآوری دادههای سری زمانی را توضیح میدهد.
معماری یک سامانهٔ مانیتورینگ حرفهای
معماری دقیق به تعداد دستگاهها، پراکندگی شعب، حجم داده و اهمیت سرویسها بستگی دارد، اما معمولاً این اجزا را در بر میگیرد:
- منابع داده: روترها، سوئیچها، فایروالها، سرورها، سرویسها و تجهیزات محیطی.
- لایهٔ جمعآوری: سرور مانیتورینگ، Agent، Poller، Proxy یا Exporter متناسب با روش اندازهگیری.
- ذخیرهسازی و پردازش: نگهداری تاریخچه، محاسبهٔ نرخ تغییر و ارزیابی قواعد هشدار.
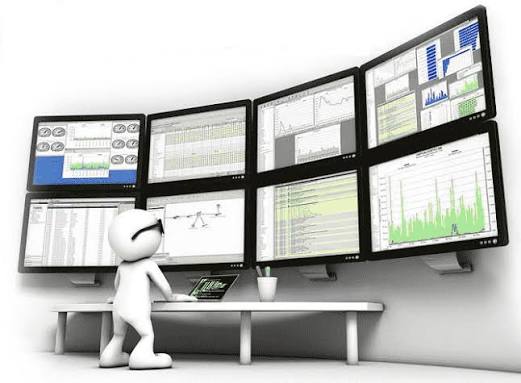
- داشبورد و گزارش: نمایش وضعیت کنونی، روند تغییرات، ظرفیت و رخدادهای مهم.
- سامانهٔ اعلان: ارسال هشدار به مسئول مناسب از طریق کانالهای تعریفشده و ثبت نتیجهٔ رسیدگی.
در شبکههای چندشعبهای، پراکسی یا نقاط جمعآوری نزدیک به شعب میتوانند به کاهش نیاز به ارتباط مستقیم با تکتک دستگاهها کمک کنند. مسیر دسترسی مدیریتی، احراز هویت، دسترسی کاربران و ظرفیت ذخیرهسازی را از ابتدا در طراحی لحاظ کنید.
انتخاب ابزار مناسب مانیتورینگ شبکه
هیچ ابزار واحدی برای همهٔ زیرساختها بهترین انتخاب نیست. ابزار باید با نوع تجهیزات، بودجه، مهارت تیم، شیوهٔ استقرار، مقیاس داده و نیازهای گزارشگیری سازگار باشد.
| ابزار یا خانواده | مناسب برای | ملاحظهٔ انتخاب |
|---|---|---|
| Zabbix | پایش تجهیزات، سرورها، شاخصها و هشدارها در محیطهای متنوع | طراحی قالبها، فاصلهٔ Polling و ظرفیت سرور را متناسب با تعداد آیتمها تنظیم کنید. |
| LibreNMS | پایش زیرساخت شبکه با اتکا به قابلیتهای دستگاهها و SNMP | پشتیبانی مدل تجهیزات، کشف دستگاه و نیازهای گزارشگیری را بررسی کنید. |
| PRTG | پایش شبکه با رابط تصویری و حسگرهای متناسب با نیاز | مدل مجوز، تعداد حسگرها و هزینهٔ رشد زیرساخت را در نظر بگیرید. |
| Prometheus و Grafana | گردآوری شاخصهای عددی، ترسیم روندها و نمایش داشبورد | برای هر نوع دستگاه یا سرویس، مسیر درست و امن دریافت شاخصها را طراحی کنید. |
پیش از انتخاب نهایی، یک نمونهٔ کوچک از تجهیزات واقعی را تحت پایش قرار دهید. کیفیت داده، مصرف منابع، سادگی ساخت هشدار، امکان گرفتن نسخهٔ پشتیبان و هزینهٔ نگهداری را در عمل بسنجید. راهنمای مانیتورینگ ترافیک شبکه در Zabbix نمونهای از جمعآوری نرخ ورودی و خروجی و تنظیم Trigger ارائه میکند.
طراحی هشدارهایی که واقعاً به کار میآیند
یکی از خطاهای رایج این است که هر افزایش کوتاهمدت یا هر رویداد جزئی بلافاصله یک اعلان تولید کند. انبوه هشدارهای تکراری باعث میشود تیم فنی اعلان مهم را دیر تشخیص دهد یا به آن بیتوجه شود.
برای هر هشدار باید روشن باشد چه مسئلهای شناسایی شده، چه کسی مسئول رسیدگی است و اقدام بعدی چیست. این اصول به طراحی قواعد هشدار قابل اقدام و کاهش نویز کمک میکنند.
- شدت را مشخص کنید: هشدار بحرانی، هشدار مهم و اطلاعرسانی عادی باید معنای متفاوت داشته باشند.
- مدت و تداوم را لحاظ کنید: برای شاخصهای متغیر، عبور کوتاه از آستانه را با مشکل پایدار اشتباه نگیرید.
- آستانه را بر اساس خط مبنا تعیین کنید: رفتار طبیعی یک لینک اینترنتی با رابط مدیریتی یا ارتباط بین سرورها یکسان نیست.
- هشدارهای وابسته را گروهبندی کنید: قطع روتر اصلی ممکن است تعداد زیادی هشدار ثانویه ایجاد کند؛ بهتر است سامانه علت بالادستی را نیز نشان دهد.
- متن هشدار را مفید بنویسید: نام دستگاه، رابط، مقدار مشاهدهشده، آستانه، زمان شروع و پیوند داشبورد را درج کنید.
- مسیر اعلان را آزمایش کنید: ارسال ایمیل یا پیام را عملاً آزمایش کنید و زمانبندی و مسئول دریافت را مستند نگه دارید.
برای تنظیم مقصد و مسیر اعلانها، مستندات Prometheus Alerting و راهنمای اعلانهای Grafana منابع مناسبی هستند.
نمونهٔ عملی: تشخیص اشباع پهنای باند
فرض کنید کاربران یک شعبه از کندی نرمافزار سازمانی شکایت دارند. در چنین موقعیتی، افزایش ناگهانی ظرفیت اینترنت یا تعویض فوری روتر نباید اولین اقدام باشد. ابتدا باید شواهد را کنار هم قرار داد.
- دسترسپذیری روتر، وضعیت رابط WAN و سلامت لینک بالادستی را بررسی کنید.
- نرخ ترافیک ورودی و خروجی را در بازهٔ شروع شکایت با زمانهای عادی مقایسه کنید.
- خطاها و Discardهای رابط، تأخیر و افت بسته را بررسی کنید.
- با استفاده از دادههای جریان، در صورت پشتیبانی تجهیزات، مشخص کنید کدام مقصدها یا سرویسها سهم قابلتوجهی از ترافیک دارند.
- یک آزمون از خود سرویس سازمانی انجام دهید تا روشن شود مشکل تنها به ظرفیت لینک مربوط است یا در بخش دیگری از مسیر رخ میدهد.
- پس از اقدام اصلاحی، شاخصها را دوباره اندازه بگیرید و نتیجه را ثبت کنید.
در این سناریو ممکن است علت، دانلود حجیم، نسخهٔ پشتیبان زمانبندیشده، خطای رابط یا اشکال یک سرویس باشد. نتیجهگیری باید بر اساس شواهد باشد، نه تنها یک نمودار یا یک تست Ping.
مراحل استقرار مانیتورینگ در سازمان
- موجودی شبکه را تهیه کنید: دستگاهها، مدل، آدرس مدیریتی، نقش، شعبه، مالک سرویس و اهمیت کسبوکار را ثبت کنید.
- سرویسهای حیاتی را اولویتبندی کنید: اینترنت، ارتباط بین شعب، DNS، سرویس احراز هویت، سامانههای مالی و زیرساختهای ضروری را مشخص کنید.
- روش جمعآوری را انتخاب کنید: برای هر دستگاه بر اساس قابلیت و نیاز، SNMP، Agent، API، Flow یا آزمون سرویس را در نظر بگیرید.
- دسترسی امن بسازید: شبکهٔ مدیریت، محدودیت مبدأهای مجاز، حسابهای اختصاصی و نگهداری امن اطلاعات دسترسی را تعریف کنید.
- داشبورد و هشدارهای اولیه را پیاده کنید: از شاخصهای کم اما مهم آغاز کنید و بعد از مشاهدهٔ خط مبنا، آستانهها را تنظیم کنید.
- خرابی کنترلشده را آزمایش کنید: مسیر اعلان، تشخیص قطعی، ثبت رویداد و دستورالعمل پاسخگویی را در محیط مجاز امتحان کنید.
- مستندسازی و بازبینی را ادامه دهید: تغییرات تجهیزات، مالک هشدار، روش عیبیابی و نیاز ظرفیت را بهروز نگه دارید.
اگر هنوز سامانهٔ مشخصی برای زیرساخت انتخاب نشده است، مقالهٔ راهنمای راهاندازی سیستمهای مانیتورینگ و گزارشگیری در شبکه را برای مراحل اجرایی بخوانید. برای آشنایی با Zabbix نیز مقالهٔ معرفی و کاربرد Zabbix در مانیتورینگ شبکه مفید است.
خطاهای رایج در پیادهسازی مانیتورینگ
- پایش تعداد زیادی شاخص بدون تعریف کاربرد عملی برای هرکدام؛
- اعتماد به Ping بهعنوان تنها معیار سلامت شبکه؛
- استفاده از اطلاعات دسترسی ضعیف یا در معرض دسترس در سرویسهای مدیریتی؛
- تنظیم آستانههای یکسان برای همهٔ دستگاهها، بدون توجه به خط مبنا؛
- بیتوجهی به ظرفیت سرور مانیتورینگ، حجم تاریخچه و نگهداری دادهها؛
- نداشتن مسئول مشخص برای هشدارها و نبود دستورالعمل رسیدگی؛
- نادیدهگرفتن تغییرات، رخدادهای امنیتی و تجربهٔ واقعی کاربران.
پرسشهای متداول دربارهٔ مانیتورینگ شبکه
آیا مانیتورینگ فقط برای شبکههای بزرگ لازم است؟
خیر. حتی یک شبکهٔ کوچک با چند سوئیچ، روتر، سرور و سرویس حیاتی میتواند از پایش دسترسپذیری و هشدار مناسب بهرهمند شود. مقیاس ابزار باید متناسب با اندازه و اهمیت زیرساخت انتخاب شود.
آیا برای مانیتورینگ حتماً باید Agent نصب کنیم؟
خیر. برای تجهیزات شبکه میتوان از SNMP و روشهای دیگر استفاده کرد؛ در سیستمعاملها و برنامهها نیز Agent، API یا Exporter ممکن است گزینهٔ مناسبتری باشد. روش درست به نوع داده و قابلیت منبع بستگی دارد.
تفاوت مانیتورینگ شبکه و SIEM چیست؟
مانیتورینگ شبکه بر عملکرد، دسترسپذیری و شاخصهای عملیاتی تأکید دارد. SIEM دادههای امنیتی را برای همبستهسازی و شناسایی الگوهای مشکوک تحلیل میکند. این سامانهها میتوانند اطلاعات مکمل یکدیگر را مصرف کنند، اما هدف و کاربردشان یکسان نیست.
هر چند وقت یکبار باید شاخصها جمعآوری شوند؟
بازهٔ جمعآوری به حساسیت شاخص، حجم شبکه، توان تجهیزات و نیاز به تشخیص سریع بستگی دارد. فاصلهٔ کوتاهتر دادهٔ بیشتری تولید میکند و میتواند بار اضافی ایجاد کند؛ بنابراین باید با آزمون عملی و بر اساس هدف پایش تنظیم شود.
از کجا بفهمیم سامانهٔ مانیتورینگ مؤثر است؟
زمان تشخیص رخداد، زمان رسیدگی، تعداد هشدارهای بیاثر، پوشش تجهیزات حیاتی و توانایی بازسازی علت اختلال را بررسی کنید. تعداد داشبوردها یا هشدارها بهتنهایی معیار موفقیت نیست.
جمعبندی
مانیتورینگ حرفهای شبکه ترکیبی از شاخصهای درست، جمعآوری امن و قابل اعتماد داده، داشبوردهای هدفمند و هشدارهای قابل اقدام است. با اولویتدادن به سرویسهای حیاتی، تعریف خط مبنا، بررسی همزمان چند نشانه و ثبت نتیجهٔ رسیدگی، میتوان تشخیص اختلال و برنامهریزی ظرفیت را بهبود داد. انتخاب ابزار تنها یک بخش از کار است؛ فرایند نگهداری و پاسخگویی نیز باید از ابتدا طراحی شود.